让计算机,看懂一张脸。
从摄像头采集到特征比对,六个环节一步步看清机器如何「认人」。使用左侧目录切换人脸识别、视频识别和 K-means 表情聚类。
🧭 人脸识别的六个环节
人脸识别不是一步完成的。从摄像头到「这是谁」,中间要经过六道工序。
💡 点击上面任一个环节,直接跳到对应的演示页面。
📷 环节①②:人脸采集与人脸检测
采集只负责「获取画面」,检测负责回答一个问题:这张图里,脸在哪里?
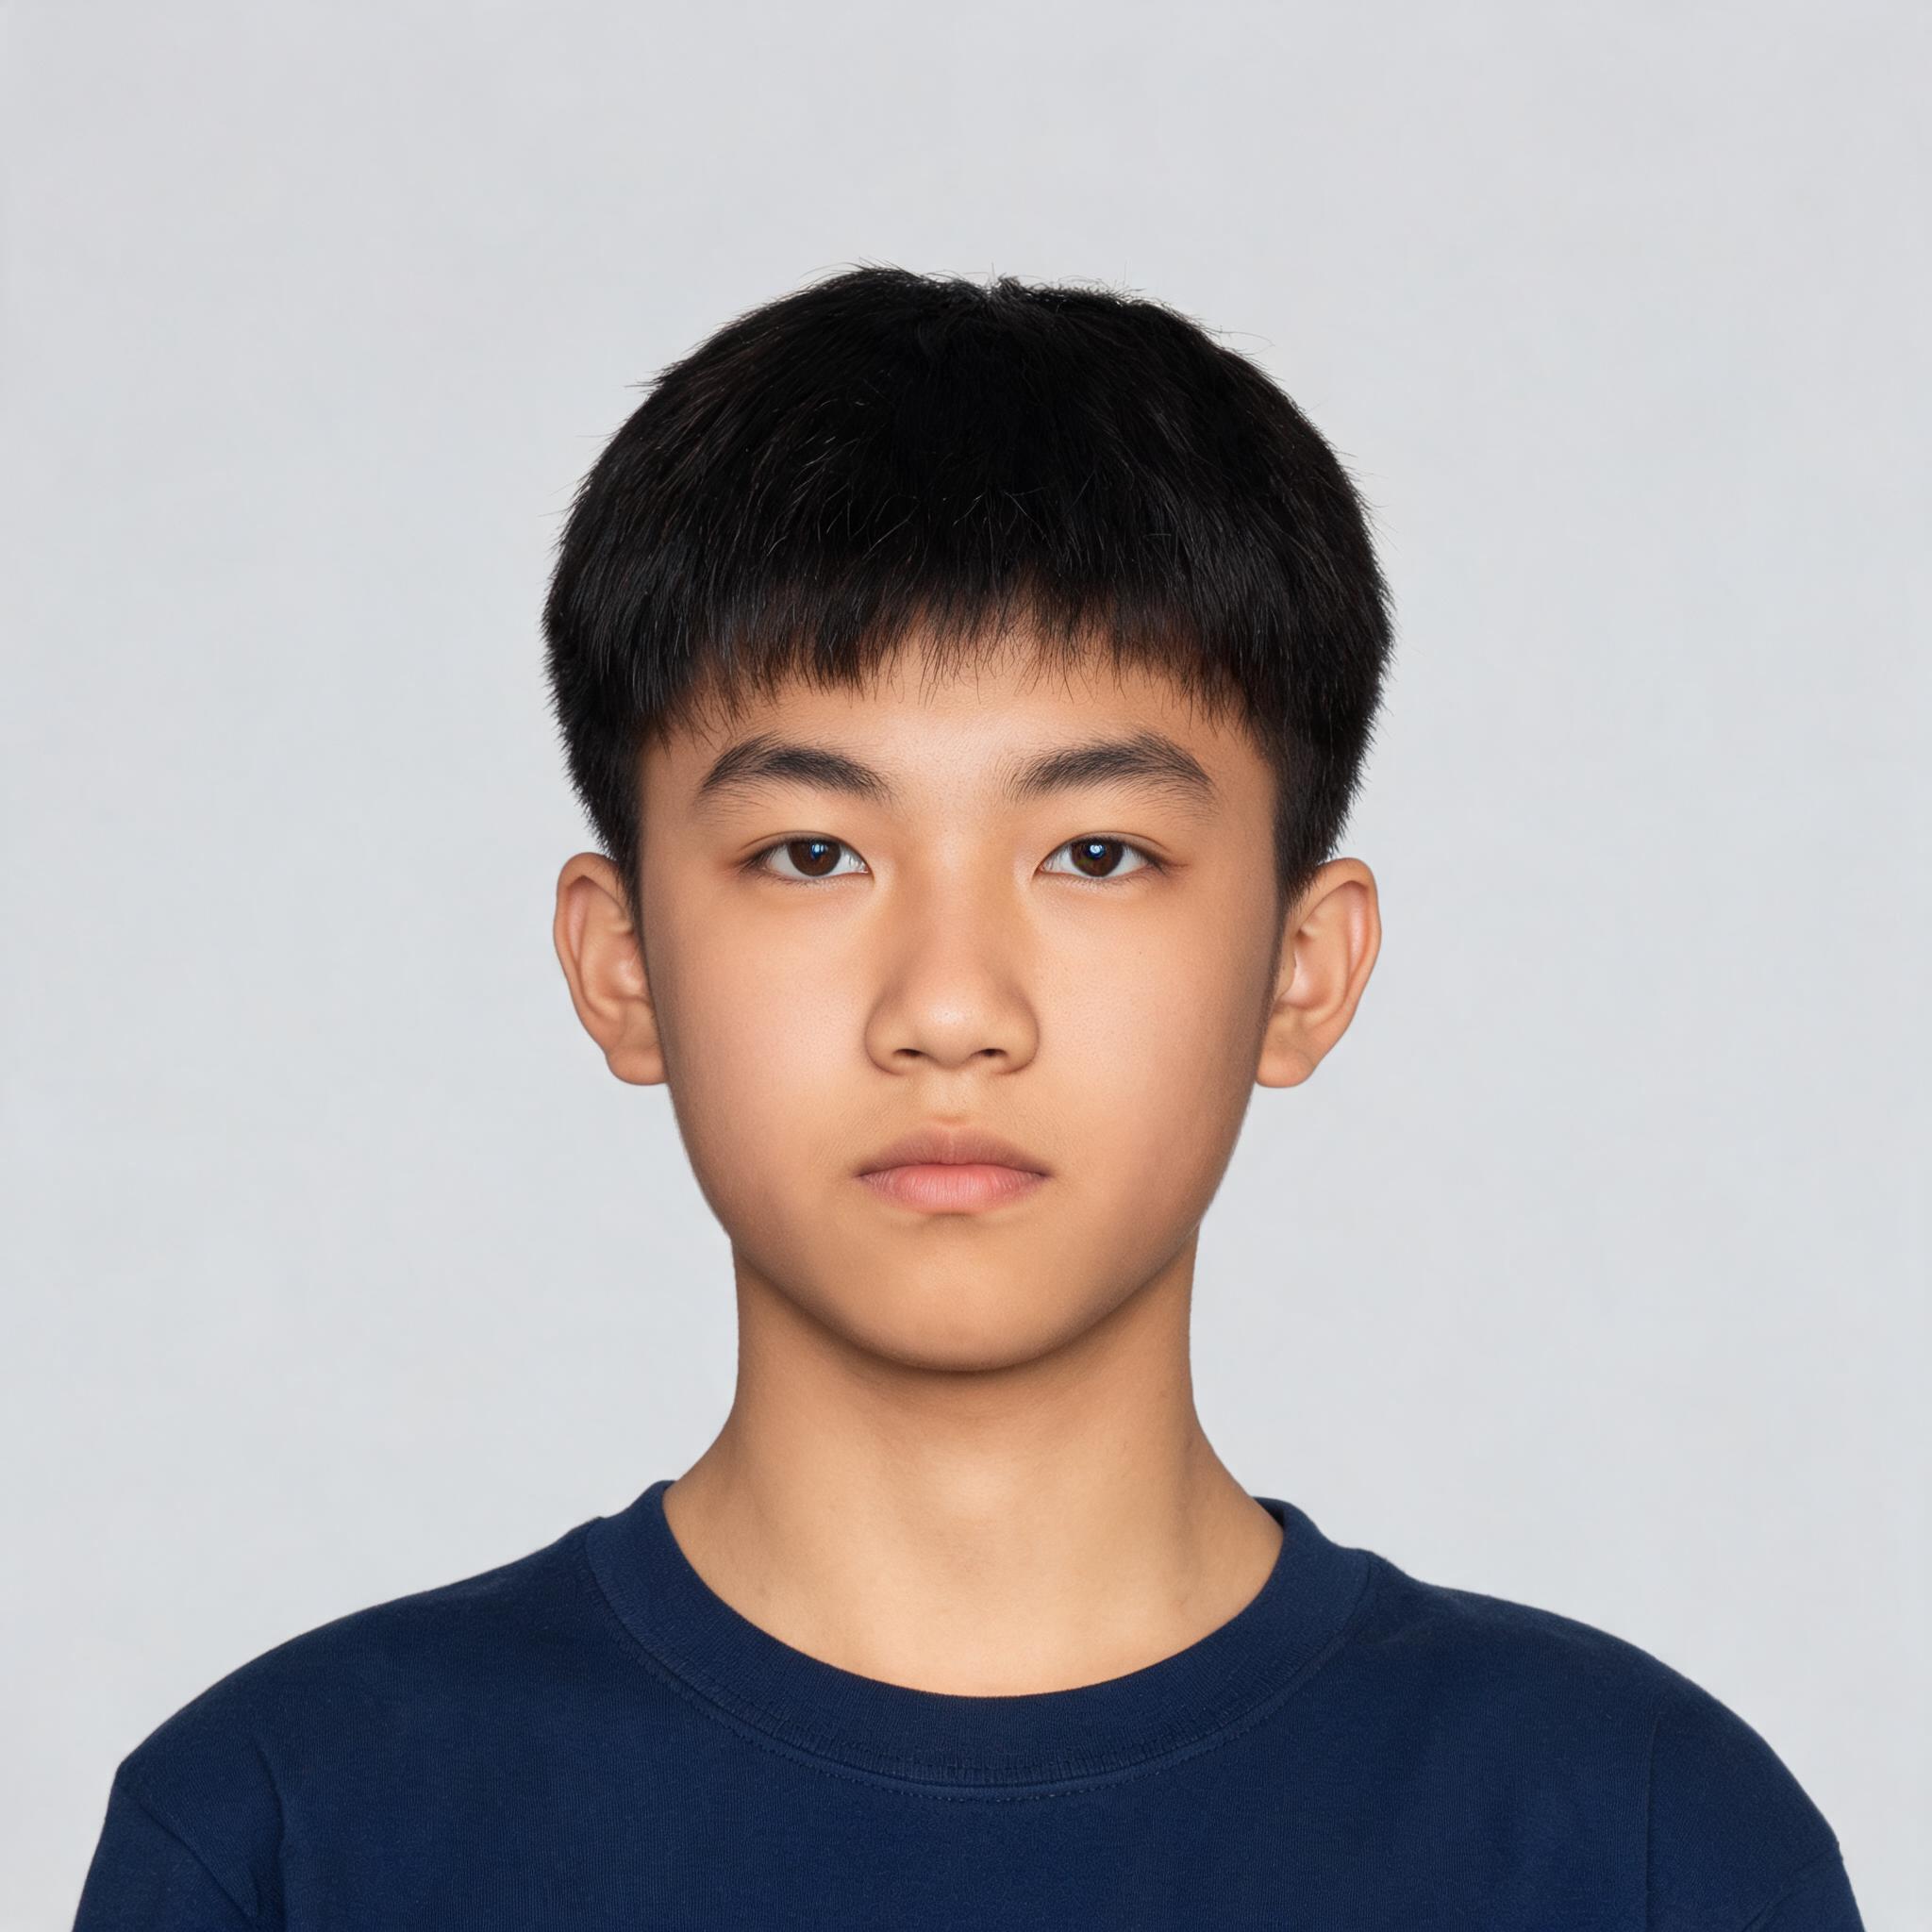
- 采集做什么?通过摄像头、摄像机或录像设备,把现实中的人脸转换为图像或视频帧,作为后续处理的输入。
- 采集设备:摄像头 / 摄像机 / 录像设备。
- 本步骤暂不判断身份:采集只负责「获取画面」。此时还没有进行人脸定位、特征提取或身份识别。
-
1
扫描输入画面
对采集到的图像或视频帧进行逐区域分析,寻找可能的人脸。
-
2
定位人脸区域
在画面中标出人脸边界框,并给出检测置信度。
-
3
输出检测结果
把定位到的人脸区域交给下一步「人脸图像预处理」。
🧹 环节③:人脸图像预处理
把不可控的「野性」人脸,变成可比对的「标准」人脸。
同一张脸,换个光照、角度、距离拍出来差别很大。如果不先统一,这些差异会被后面的网络误当成「不同的脸」。
环节④:人脸特征提取(68 个关键点)
使用 TinyFaceDetector + FaceLandmark68Net 在每张脸上回归 68 个特征点
Facial Landmarks · 68 Points
68 个面部关键点
TinyFaceDetector 完成人脸检测,FaceLandmark68Net 在脸上回归 68 个特征点, 覆盖脸颊轮廓、双眉、眼睛、鼻梁、嘴部。
⚠️ 能力边界
· 模型基于公开人脸数据集训练,浅色人种 / 正面光线下表现最好
· 强逆光、侧脸超过 60°、口罩 / 墨镜遮挡时关键点会漂移
· 同时检测多张人脸时,远处的小脸可能漏检
· TinyFaceDetector 是为速度优化的轻量模型,精度低于服务端方案
点越多,脸部轮廓越精细,但计算量也增加。
本演示模型固定输出 68 点;拖到 106 仍按 68 点显示,用来说明不同密度模型的差别。
阈值越低检出越多(也越容易误检),越高越严格。
拖动会立刻影响本页的检测框与关键点,可以现场对比效果。
拓展:人脸表情识别
FaceExpressionNet 对 7 类基础情绪同时输出概率
Expression Recognition
本模型基于 FER2013(35,887 张 48×48 灰度图)训练,是浏览器端轻量方案,识别精度天然有限:
· 训练集本身存在标注偏差,人类标注一致率仅约 65%
· 对 东亚人脸表情 不如西方人脸样本表现好
· 微表情、混合情绪(如苦笑、勉强)无法识别
· 仅供体验和教学演示,不可用于真实情感判断
--
💡 点击每个表情右侧的 i 图标查看经典动作要点,可对照模仿测试识别效果。
拓展:年龄性别识别
AgeGenderNet 同时输出预估年龄和性别(仅供娱乐,结果有误差)
Age & Gender
模型基于 UTKFace 数据集训练,对侧脸、化妆、特殊角度容易判断不准; 仅供体验,不要拿来当真。
用上传图片可以试试不同年龄段的照片,观察预测的偏差范围。
环节⑤:人脸匹配(1:1 比对)
提取两张脸的 128 维特征向量,计算欧氏距离判断是否为同一人
◉ 环节⑥:人脸图像识别与应用
匹配算出分数之后,系统要给出结论——这就是「识别」。它分两种模式。
把采集到的人脸与「已声称身份的这个人」的模板比对,答对 / 不对。手机解锁、刷脸支付都属于这一类。
把采集到的人脸与库中 N 个人的模板逐一比对,找出最像的那个(或查无此人)。校园闸机、考勤打卡属于这一类。
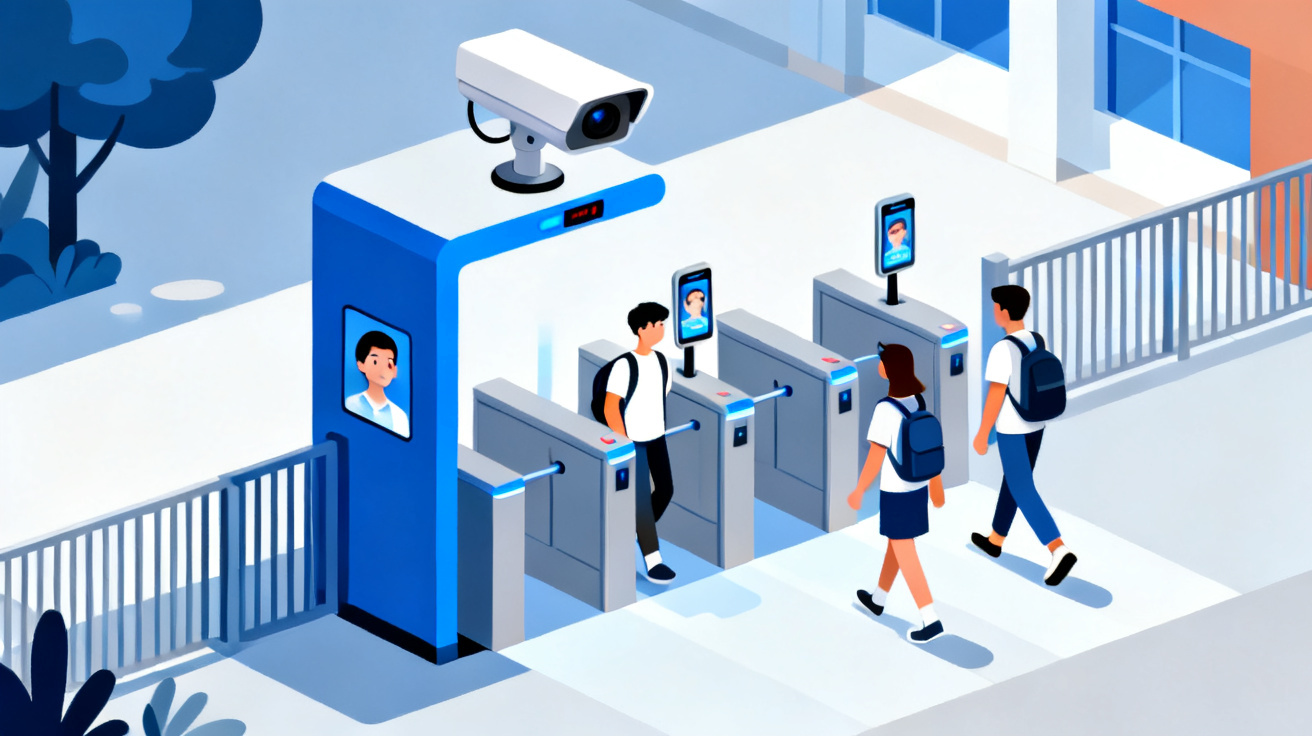
在已注册学生库中比对,识别身份后放行。
1:N 辨识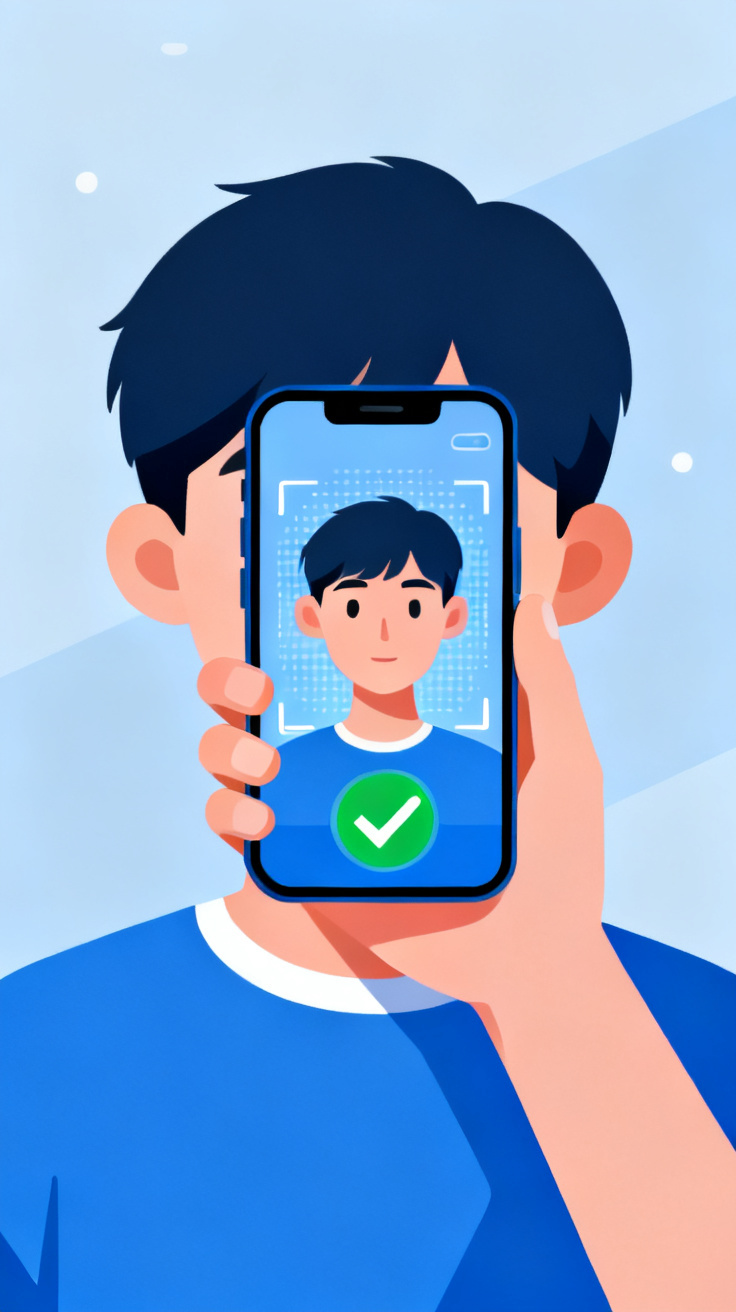
将摄像头采集的脸与机主特征比对。
1:1 验证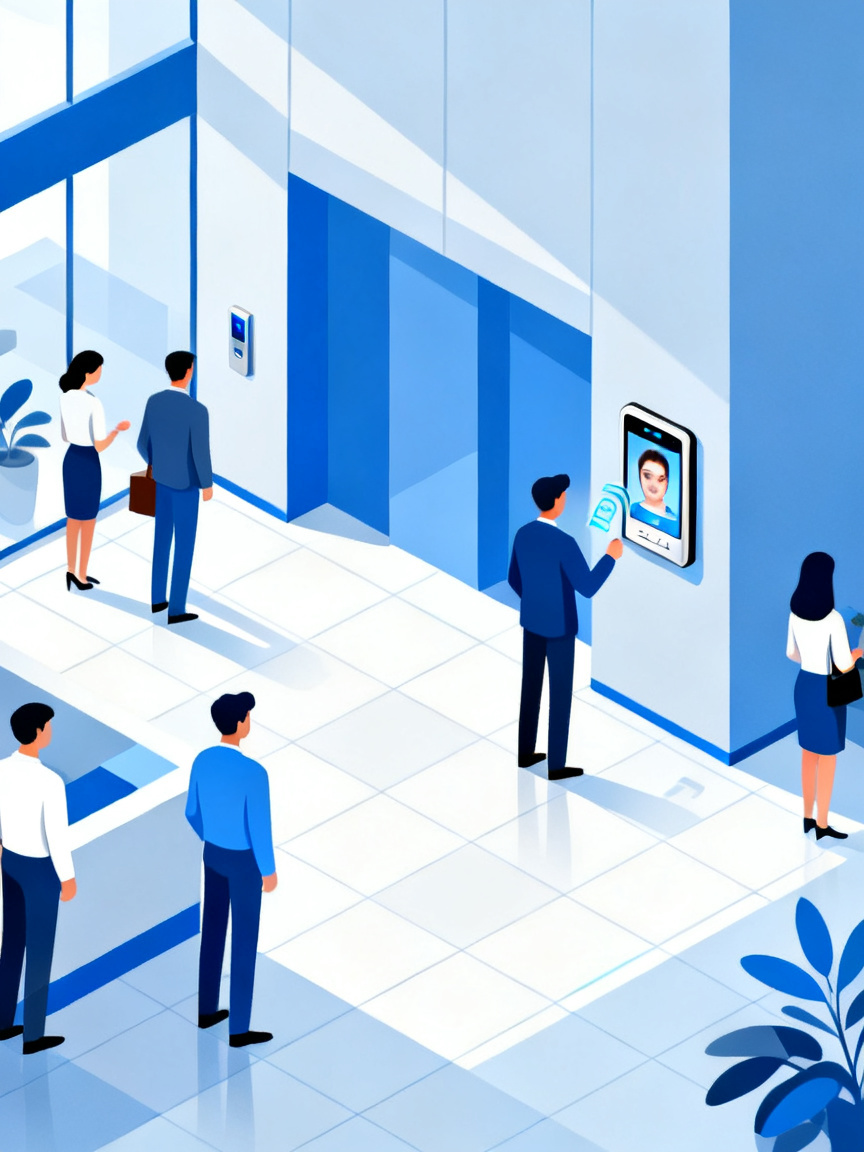
在员工库中辨识身份并记录考勤。
1:N 辨识
输入手机号确认身份后比对人脸。
1:1 验证不会存照片。系统只保存 一串数字(特征向量),原始图像处理完即丢弃。
好处有三:省空间(几 KB 的向量 vs 几十 KB 的图片)、护隐私(向量很难反推出人脸)、比对快(只需算向量距离)。